

На этой неделе мы выпустили первую бета Astro 5, включающую совершенно новый способ работы с контентом в Astro. Этот пост — подробный разбор Content Layer API: как он работает и как использовать его для построения сайтов.
Astro создан для контентных сайтов. Хотя теперь им можно строить и динамические приложения, он по-прежнему лучше всего подходит для сайтов, построенных вокруг большого объёма контента. От полнофункциональных docs-сайтов на Starlight вроде Cloudflare и StackBlitz до красивых маркетинговых сайтов для брендов вроде Porsche и Netlify — миллионы пользователей каждый день оценивают быстрые и доступные сайты на Astro, а тысячи инженеров любят лучший developer experience в индустрии.
В Astro 2 мы представили Content Collections как мощный способ организовать локальный контент, строить с типобезопасностью и масштабироваться до тысяч страниц. Content Collections дают лучший в классе developer experience для локальных файлов вроде Markdown и MDX, но мы слышали от вас, что хотите те же преимущества для всего контента, включая удалённые API. Также стало ясно, что хотя многие строят сайты с тысячами страниц, наш Content Collections API с трудом масштабировался до десятков тысяч страниц — с более медленными сборками и чрезмерным потреблением памяти.
В июне мы поделились ранним превью плана решить эти и другие проблемы с совершенно новым типом content collection на базе Content Layer API, дающим запрошенную гибкость. Мы представляли коллекции за пределами файлов в src/content, позволяя загружать контент откуда угодно. Мы тестировали коллекции, масштабирующиеся до ранее невозможных размеров. С первого экспериментального релиза в Astro 4.14 мы усердно работали над стабилизацией API для релиза в Astro 5.
Что такое Content Layer
Content Layer API — будущее content collections, которые вы знаете и любите. Он позволяет загружать данные из любого источника при сборке сайта, а затем обращаться к ним на странице через простой типобезопасный API.
Content Layer API не заботится о том, где хранятся данные. Одна коллекция может оставаться локальными Markdown-файлами, другая — вызывать API, третья — жить в другом месте файловой системы. С теми же функциями getEntry() и getCollection(), что и раньше, можно загружать данные из многих источников на одной странице. Без потери производительности: Astro кэширует данные локально между сборками, обновления быстрые и минимизируется число API-вызовов. И конечно, всё по-прежнему типобезопасно — TypeScript-типы автогенерируются из схемы.
Если вы использовали content collections раньше, многие концепции и термины покажутся знакомыми. Фактически, мы почти не изменили использование коллекций в проекте! Коллекция — по-прежнему наш термин для набора записей с общей схемой. Каждая запись имеет уникальный ID. Это аналог таблицы в реляционной базе данных.
Теперь каждая коллекция использует loader, определяющий, как записи загружаются для заполнения коллекции. Loader может быть простой inline-функцией, возвращающей массив записей, или более продвинутым объектом со своим кэшированием и data store. Первые loaders уже распространяются как модули на npm.
При каждой сборке сайта loader каждой коллекции вызывается и обновляет локальный data store. Этот data store можно запрашивать знакомыми функциями getCollection() и getEntry(). Это делается на этапе сборки для prerendered страниц или во время server rendering при on-demand adapter. В обоих случаях доступны одни и те же данные — снимок на момент сборки.
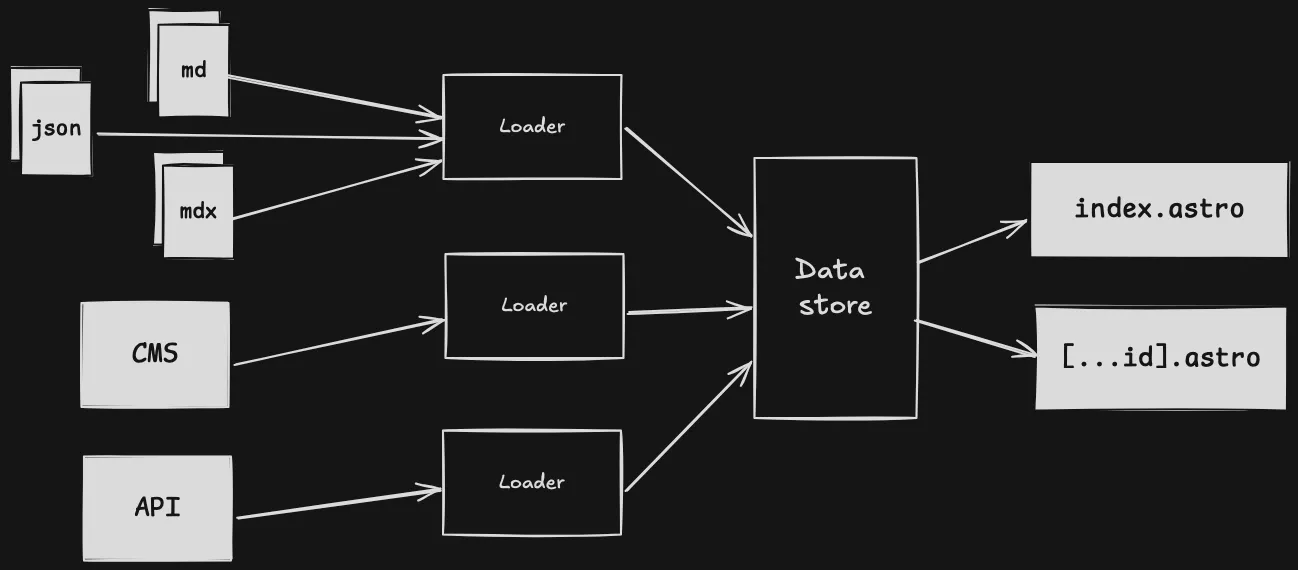
Создание коллекций
Определяйте content collections в src/content/config.ts, который у вас уже есть, если вы использовали коллекции раньше. Новое свойство loader определяет источник данных и может быть таким простым, как async-функция, возвращающая массив элементов:
import { defineCollection, z } from 'astro:content';
const countries = defineCollection({  loader: async () => {    const response = await fetch('https://restcountries.com/v3.1/all');    const data = await response.json();    // Must return an array of entries with an id property, or an object with IDs as keys and entries as values    return data.map((country) => ({      id: country.cca3,      ...country,    }));  },  // optionally define a schema using Zod  schema: z.object({    id: z.string(),    name: z.string(),    capital: z.array(z.string()),    population: z.number(),    // ...  }),});
export const collections = { countries };
Эти данные затем доступны в .astro компонентах, как и раньше:
---import type { GetStaticPaths } from 'astro';import { getCollection } from 'astro:content';
export const getStaticPaths: GetStaticPaths = async () => {  const collection = await getCollection('countries');  if (!collection) return [];  return collection.map((country) => ({    params: {      id: country.id,    },    props: {      country,    },  }));};
const { country } = Astro.props;---
<h1>{craft.data.name}</h1><p>Capital: {craft.data.capital}</p>
Нас уже устраивал этот опыт запроса и рендеринга данных на странице, поэтому мы обратили внимание на механику под капотом. Давайте погрузимся в то, как Content Layer API организует, управляет и использует ваш контент!
Жизненный цикл content layer
При запуске astro build или astro dev loader каждой коллекции вызывается параллельно. Эти loaders обновляют свой scoped data store, сохраняемый между сборками.
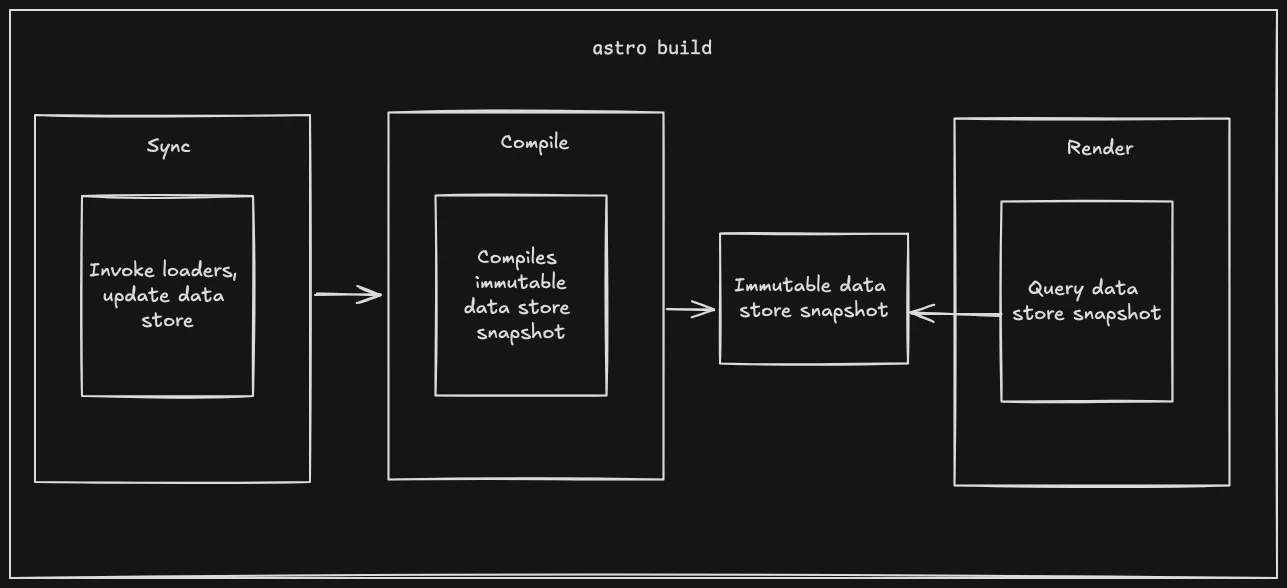
Astro-компоненты и страницы затем могут использовать getCollection или getEntry для запроса данных. Данные на этом этапе неизменяемы, поэтому все страницы запрашивают один и тот же снимок, скомпилированный на этапе сборки. Это относится и к prerender на этапе сборки, и к server rendering по требованию. Важно: data store обновляется только на этапе сборки — задеплоенный сайт не может изменить data store. Если источник данных должен обновить коллекцию, он должен запустить новую сборку.
Хотя в продакшене неизменяем, при astro dev data store можно обновлять по требованию с горячей клавишей s+enter или через интеграции. Это можно делать разными способами — регистрировать development refresh endpoint или открывать socket к CMS для прослушивания обновлений.
Как работает loader
Первый пример показал простой inline loader, но на этом можно не останавливаться. С object loader API можно создавать мощные loaders с продвинутыми возможностями. Object loader взаимодействует с content layer через объект data store — key-value store, scoped к отдельной коллекции. Коллекция может обращаться только к своим записям, но имеет полный контроль над ними. Если loader знает, что источник данных не изменился, он может пропустить обновление целиком или обновить только изменившиеся записи.
Content Layer API предоставляет инструменты для упрощения. Первый — metadata store для произвольных значений вроде времени «last modified» или sync tokens. Сравнение позволяет loader делать условные API-запросы или использовать delta sync APIs.
Этот пример показывает это с RSS feed loader. Он хранит last modified header в metadata store и использует его для условных запросов при следующей загрузке feed:
export function feedLoader({ url }: FeedLoaderOptions): Loader {  const feedUrl = new URL(url);  // Return a loader object  return {    // The name of the loader. This is used in logs and error messages.    name: 'feed-loader',    // The load method is called to load data    load: async ({ store, logger, meta }) => {      // Check if there's a last-modified time already stored      const lastModified = meta.get('last-modified');
      // If so, make a conditional request for the feed      const headers = lastModified ? { 'If-Modified-Since': lastModified } : {};
      const res = await fetch(feedUrl, { headers });
      // If the feed hasn't changed, you do not need to update the store      if (res.status === 304) {        logger.info('Feed not modified, skipping');        return;      }      if (!res.ok || !res.body) {        throw new Error(`Failed to fetch feed: ${res.statusText}`);      }
      // Store the last-modified header in the meta store so we can      // send it with the next request      meta.set('last-modified', res.headers.get('last-modified'));
      // ... now store the data    },  };}
Если контент изменился, можно либо очистить store и заменить всё, либо инкрементально обновлять отдельные записи, если источник данных даёт такой уровень детализации.
export function feedLoader({ url }: FeedLoaderOptions): Loader {  const feedUrl = new URL(url);  // Return a loader object  return {    // The name of the loader. This is used in logs and error messages.    name: 'feed-loader',    // The load method is called to load data    load: async ({ store, logger, meta }) => {      // Check if there's a last-modified time already stored      const lastModified = meta.get('last-modified');
      // If so, make a conditional request for the feed      const headers = lastModified ? { 'If-Modified-Since': lastModified } : {};
      const res = await fetch(feedUrl, { headers });
      // If the feed hasn't changed, you do not need to update the store      if (res.status === 304) {        logger.info('Feed not modified, skipping');        return;      }      if (!res.ok || !res.body) {        throw new Error(`Failed to fetch feed: ${res.statusText}`);      }
      // Store the last-modified header in the meta store so we can      // send it with the next request      meta.set('last-modified', res.headers.get('last-modified'));
      const feed = parseFeed(res.body);
      // If the loader doesn't handle incremental updates, clear the store before inserting new entries      // In some cases the API might send a stream of updates, in which case you would not want to clear the store      // and instead add, delete, or update entries as needed.      store.clear();
      for (const item of feed.items) {        // The parseData helper uses the schema to validate and transform data        const data = await parseData({          id: item.guid,          data: item,        });
        // The generateDigest helper lets you generate a digest based on the content. This is an optional        // optimization. When inserting data into the store, if the digest is provided then the store will        // check if the content has changed before updating the entry. This will avoid triggering a rebuild        // in development if the content has not changed.        const digest = generateDigest(data);
        store.set({          id,          data,          // If the data source provides HTML, it can be set in the `rendered` property          // This will allow users to use the `<Content />` component in their pages to render the HTML.          rendered: {            html: data.description ?? '',          },          digest,        });      }    },  };}
Когда не использовать content collections
Раньше было ясно, когда content collections — хорошая идея: всегда, когда вы используете локальный контент на страницах! Content Layer API даёт гораздо больше мощи и гибкости, потому что его можно использовать для любого источника контента, включая live APIs. Однако важно помнить: данные обновляются только при сборке сайта, поэтому он не покроет каждый use case.
Это значит, что коллекции идеальны, когда данные меняются относительно редко, например блог. Если блог в CMS, можно запускать сборку webhook при публикации нового поста. Инкрементальные обновления content layer должны сделать эту сборку быстрой.
То же для большинства e-commerce сайтов — сборка при редактировании продукта. Если вас устраивает ждать время деплоя для публикации обновлений, content collections по-прежнему очевидный выбор. Вы получите лучшую производительность и отличный developer experience.
Если страницам нужны обновления почти в реальном времени или персонализированный контент, лучше использовать on-demand rendering adapter, желательно с CDN cache headers для сверхбыстрой загрузки. Можно даже комбинировать оба подхода с server islands — лучшее из обоих миров: основной контент через content collections, а real-time или персонализированный — через server island.
Что дальше
Content Layer API — большой шаг вперёд для Astro, но мы только начинаем. Сейчас data store — просто key-value store с ограниченной фильтрацией. Это быстро, но не memory efficient, и запросы не очень гибкие. Наша цель — ввести backend на базе Astro DB в будущей версии для масштабирования до сотен тысяч страниц. Это также позволит поддерживать более сложные запросы и, возможно, даже real-time обновления.
Тем временем мы будем рады вашей обратной связи по Content Layer API! Попробуйте мигрировать существующие сайты. (Это легко, обещаем!) и расскажите, как прошло. Попробуйте новые loaders от сообщества или создайте свой для любимого API. Мы с нетерпением ждём, что вы построите!